Detektor treści AI nie dostarcza dowodu autorstwa: jego wynik zależy od metody, danych treningowych, progu decyzyjnego, języka i domeny tekstu. W badaniu opublikowanym w czasopiśmie „Patterns” (Liang i in., 2023) siedem ówczesnych detektorów uznało średnio 61,22 procent esejów pisanych przez osoby nienatywnie władające angielskim za wygenerowane przez model, przy niemal bezbłędnej ocenie esejów autorów natywnych. Późniejsze prace pokazują jednak, że nie jest to nieusuwalna cecha detekcji ani zjawisko uniwersalne językowo. Dla firmy praktyczna konsekwencja jest jedna: wynik detektora można czytać wyłącznie razem z informacją, jakim narzędziem, na jakim języku i przy jakim progu powstał.
Kluczowe wnioski
- Detektory zwracają etykietę albo wynik liczbowy, nie rozstrzygnięcie o autorstwie; próg klasyfikacji bywa ustalany przez producenta, badacza albo operatora platformy i jest jedną z decyzji, które mogą istotnie zmienić wynik analizy.
- Siedem detektorów badanych w 2023 roku wykazało stronniczość wobec angielszczyzny nienatywnej (61,22% fałszywych alarmów), ale badanie na danych z egzaminu GRE (Jiang i in., „Computers & Education”, 2024, recenzowane) tej stronniczości nie potwierdziło.
- Mechanizm przenosi się między językami słabiej, niż sugeruje popularna narracja: w badaniu na języku czeskim (Al Ali i in., 2026) teksty osób nienatywnych miały wyższą, a nie niższą entropię niż teksty autorów natywnych.
- Dla polszczyzny istnieje pomiar: w zadaniu ŚMIGIEL (PolEval 2025) najlepszy system osiągnął 92,53% trafności na głównym zbiorze, a na najtrudniejszym podzbiorze, łączącym nieznany model generujący z domeną spoza treningu, najlepszy wynik spadał do 61%.
- Liczba 40 procent podana przez LinkedIn w sierpniu 2026 jest wielkością zagregowaną dla kategorii, którą serwis sam definiuje, i nie opisuje spadku zasięgu pojedynczego wpisu; serwis deklaruje, że pojedyncze zgłoszenie nie decyduje o dystrybucji, a kryteriów klasyfikacji nie ujawnia.
Czym jest detektor treści AI i czego nie rozstrzyga
Detektor treści AI to system klasyfikacyjny, który na podstawie cech tekstu zwraca etykietę albo wynik wskazujący, jak silnie tekst odpowiada wzorcom kojarzonym z treścią generowaną przez model. Wynik nie stanowi dowodu autorstwa. Narzędzie nie bada pochodzenia dokumentu, historii zmian ani metadanych; ocenia wyłącznie sam ciąg znaków.
W części rozwiązań, w tym w narzędziach analizowanych przez Lianga i współpracowników w 2023 roku, istotnym sygnałem była przewidywalność tekstu, w literaturze nazywana perplexity. Model językowy próbuje przewidzieć każde kolejne słowo, a im częściej trafia, tym niższa perplexity. Nie jest to jednak wspólna definicja całej kategorii: współczesne detektory komercyjne bywają klasyfikatorami uczonymi na parach tekstów ludzkich i maszynowych, a ich wewnętrznych sygnałów producenci zwykle nie ujawniają.
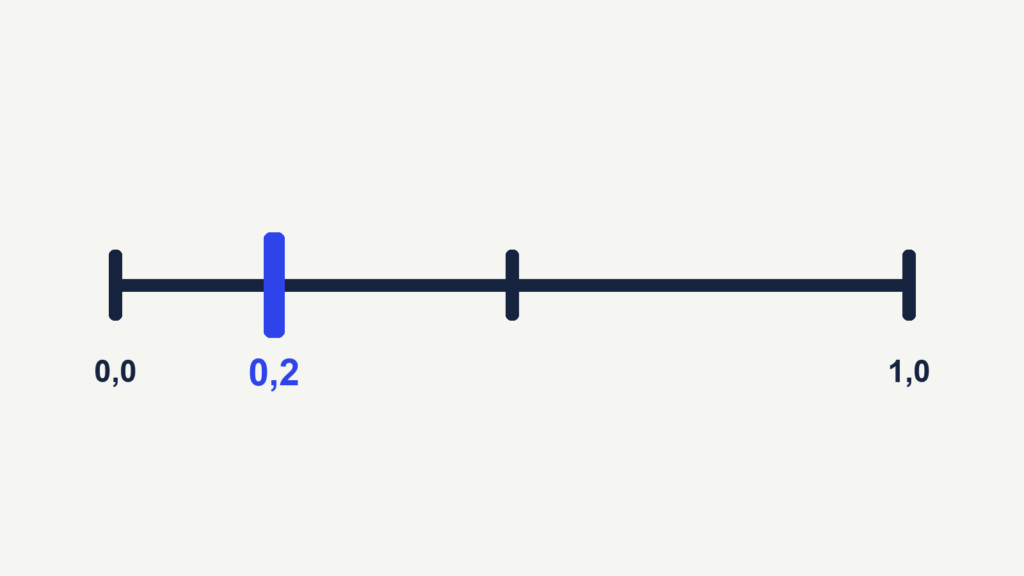
Postać wyniku różni się między narzędziami. Część zwraca wynik liczbowy od zera do jedynki, gdzie zero opisuje tekst w pełni ludzki, a jedynka w pełni maszynowy; inne zwracają kategorię, na przykład „ludzki”, „mieszany” albo „maszynowy”, z osobnym wskaźnikiem pewności. Wartość pośrednia nie jest deklaracją, jaki procent tekstu wygenerował model: to pozycja na skali ufności klasyfikatora, a nie miara udziału.
Próg, powyżej którego dokument zostaje zaklasyfikowany, bywa ustalany na trzy sposoby: przez producenta narzędzia, przez badacza projektującego analizę albo przez operatora platformy stosującej klasyfikację. W badaniu Pew Research Center z 2026 roku próg 0,2 dobrali badacze, aby skalibrować model otwarty Open Pangram do wyników komercyjnego Pangram 3.3. Próg klasyfikacji jest jedną z decyzji metodologicznych, które mogą istotnie zmienić wynik analizy.
Warto rozróżnić trzy mechanizmy, które w publicystyce bywają zlepiane. Detekcja statystyczna zgaduje po wyglądzie tekstu. Znak wodny w treściach AI to sygnał wbudowany przez dostawcę modelu w chwili generowania. Oznaczanie treści zgodnie z art. 50 aktu o sztucznej inteligencji to obowiązek deklaratywny nałożony na podmiot publikujący. Tylko pierwszy działa bez wiedzy i zgody autora.
Ile treści w sieci klasyfikatory uznają za maszynową
Dwa niezależne pomiary z 2026 roku dają wyniki od 10 procent do około połowy i oba mogą być poprawne. Różnią się jednostką analizy, doborem próbki oraz sposobem klasyfikacji, dlatego ich wyników nie można porównywać bezpośrednio.
| Pomiar | Jednostka analizy | Próbka i filtr | Sposób klasyfikacji | Wynik | Czego pomiar nie obejmuje |
|---|---|---|---|---|---|
| Pew Research Center, 2026 (pomiar) | strona internetowa | 490 tys. stron anglojęzycznych z 49 przeglądów Common Crawl, od stycznia 2021 do lipca 2026, bez filtra typu treści | jeden detektor (Open Pangram), próg 0,2 dobrany przez badaczy do kalibracji | 10% stron w migawce z lipca 2026; ponad jedna trzecia stron opublikowanych po listopadzie 2022 | języki inne niż angielski; strony za ścianą płatną niedoreprezentowane |
| Graphite, maj 2026 (pomiar) | artykuł | 55,4 tys. adresów anglojęzycznych z Common Crawl, wyłącznie ze znacznikiem artykułu i min. 100 słów, od stycznia 2020 do marca 2026 | reguła binarna zależna od detektora; wynik kwartalny to średnia z trzech narzędzi: Pangram, Copyleaks i GPTZero | 49,9% artykułów w I kw. 2026 uznanych za w przeważającej części maszynowe | języki inne niż angielski; strony niebędące artykułami |
Różnica między tymi wierszami jest pouczająca. Pew liczy strony wszelkiego rodzaju i stosuje próg 0,2 dobrany w procedurze kalibracji, podczas gdy Graphite analizuje wyłącznie artykuły i łączy wyniki trzech detektorów. To nie są dwa sprzeczne pomiary tego samego, lecz dwa pomiary czegoś innego.
Pisałem wcześniej o tym, ile internetu pisze dziś AI, opierając się na wcześniejszej edycji badania Graphite. Wersja z maja 2026 zastępuje tamte dane, obejmuje trzy detektory zamiast jednego i potwierdza kierunek zmiany.
Osobną kategorią, której z powyższymi liczbami mieszać nie wolno, są pomiary skuteczności samych detektorów. Wracam do nich niżej, po omówieniu warstwy językowej, ponieważ mają inny mianownik: nie mierzą, ile treści w sieci jest maszynowej, tylko jak często narzędzie się myli.
Jak zmienił się rozkład cech językowych w sieci
Cztery cechy językowe kojarzone z tekstem maszynowym wyraźnie zyskały na częstości w tekstach opublikowanych po listopadzie 2022. Pew mierzył je na wszystkich analizowanych stronach, a nie tylko na tych zaklasyfikowanych jako maszynowe.
| Cecha językowa | Styczeń 2023 | Styczeń 2026 | Zmiana |
|---|---|---|---|
| Myślnik (em dash) | 5,79 na 10 tys. słów | 11,19 | +93% |
| Przecinek oksfordzki | 34,04 na 10 tys. słów | 55,51 | +63% |
| Słownictwo typowe dla modeli | 11,94 na 10 tys. słów | 26,02 | +118% |
| Paralelizm negatywny | 0,87 na 10 tys. słów | 2,36 | +171% |
Źródło: Pew Research Center, „How much of the internet is written with AI?”, 2026 (pomiar).
Za „słownictwem typowym dla modeli” stoi konkretna lista, na której są między innymi wyrazy delve, testament, pivotal, tapestry, meticulous, underscore i showcase. Paralelizm negatywny to konstrukcja typu „it’s not just X, it’s Y”, czyli budowanie porównania przez zaprzeczenie pierwszego członu.
Z tych danych nie wynika, że zmienił się sposób pisania ludzi. Pomiar obejmuje całą populację stron, więc wzrost częstości może pochodzić w całości ze zwiększonego udziału treści maszynowych, bez żadnej zmiany stylu u autorów ludzkich. Rozdzielenie tych dwóch wyjaśnień wymagałoby porównania w obrębie samych tekstów ludzkich, a takiego zestawienia badanie nie zawiera.
Dla polszczyzny lista ta jest w większości bezużyteczna. Przecinka oksfordzkiego w polskim nie ma, wymienione wyrazy angielskie nie mają odpowiedników mierzalnych w ten sam sposób, a myślnik pełni w polskiej składni inną funkcję niż w angielskiej.
Kogo detektory myliły w badaniu z 2023 roku
Detektory badane w 2023 roku myliły się nieporównanie częściej na tekstach osób, dla których angielski nie był językiem pierwszym. Liang i współpracownicy ocenili siedmioma komercyjnymi narzędziami 91 esejów z egzaminu TOEFL oraz 88 esejów uczniów ósmej klasy szkół amerykańskich.
Wyniki obu grup rozeszły się drastycznie. Dla esejów TOEFL średni odsetek fałszywych alarmów wyniósł 61,22 procent. Osiemnaście z 91 esejów (19,78 procent) uznano za maszynowe jednogłośnie przez wszystkie siedem narzędzi, a 89 z 91 (97,80 procent) przez co najmniej jedno. Eseje uczniów amerykańskich oceniono z dokładnością bliską bezbłędnej.
Mechanizm autorzy wskazali wprost: eseje błędnie sklasyfikowane miały istotnie niższą perplexity (wartość p równa 9,74 na dziesięć do minus piątej). Osoba pisząca w języku obcym operuje węższym zasobem słów i prostszą składnią, więc jej tekst bywa bardziej przewidywalny.
Najciekawszy jest wynik dodatkowy. Gdy badacze przepuścili eseje TOEFL przez ChatGPT z poleceniem wzbogacenia słownictwa tak, by brzmiało bardziej natywnie, odsetek fałszywych alarmów spadł z 61,22 do 11,77 procent. Po użyciu modelu do redakcji detektory znacznie rzadziej klasyfikowały tekst jako maszynowy, choć udział modelu w powstaniu wersji końcowej był wtedy większy, a nie mniejszy.

Zakres tego wyniku jest jednak węższy, niż bywa przytaczany. Badano eseje egzaminacyjne, nie treści zawodowe, siedem konkretnych narzędzi z 2023 roku, i wyłącznie angielszczyznę. Mechanizm może mieć znaczenie także dla profesjonalistów piszących po angielsku jako drugim języku, lecz badanie nie testowało ani treści B2B, ani wpisów w mediach społecznościowych.
Czy to samo dotyczy polszczyzny
Dla języka polskiego istnieje publiczny pomiar skuteczności wykrywania tekstu maszynowego, natomiast nie ma opublikowanego pomiaru stronniczości wobec autorów nienatywnych. Zadanie ŚMIGIEL w ramach PolEval 2025 (Przybyła, Strebeyko, Wróblewska) objęło 64 tysiące próbek, po połowie ludzkich i maszynowych, w sześciu domenach i z ośmioma modelami generującymi, w tym polskimi Bielikiem i PLLuM.
Wynik główny jest dwuczęściowy i ta druga część jest ważniejsza. Najlepszy system w wariancie ograniczonym osiągnął 92,53 procent trafności na głównym zbiorze ewaluacyjnym. Na najtrudniejszym podzbiorze, łączącym nieznany wcześniej model generujący z domeną spoza treningu, trafność najlepszego podejścia spadała do 61 procent, podczas gdy metody nienadzorowane utrzymywały 71 procent. Autorzy formułują wniosek wprost: modele wykrywania tekstu maszynowego są skrajnie podatne na przeuczenie i bywają zawodne wobec danych innych niż te, które widziały w treningu.
Dwie z sześciu domen, prasa i stenogramy parlamentarne, były w tym zadaniu zarezerwowane wyłącznie do oceny. Treści firmowych i marketingowych nie badano, więc żadnej z tych wartości nie należy traktować jako szacunku skuteczności detekcji dla takich materiałów.
Osobno warto odnotować pracę, która podważa przenoszenie mechanizmu z angielszczyzny na języki słowiańskie. Al Ali, Helcl i Libovický (2026) powtórzyli badanie Lianga na języku czeskim i stronniczości wobec autorów nienatywnych nie stwierdzili. Teksty osób nienatywnie władających czeskim miały wyższą entropię niż teksty autorów natywnych (średnio 3,48 wobec 3,19), czyli odwrotnie niż w angielszczyźnie. Autorzy wiążą to z morfologią języka docelowego.
Czeski nie jest polskim, więc nie jest to dowód dla polszczyzny. Jest natomiast mocnym argumentem, że przeniesienie liczby 61,22 procent na polskiego autora piszącego po polsku byłoby nieuprawnione, ponieważ opiera się na mechanizmie, który w języku fleksyjnym zachował się inaczej.
Jak zmienia się skuteczność detekcji w różnych warunkach
Cztery badania skuteczności z lat 2023 do 2026 dają wyniki rozbieżne nie dlatego, że któreś jest błędne, lecz dlatego, że mierzyły różne narzędzia, w różnych językach i w różnych warunkach. Poniższe liczby opisują jakość klasyfikacji, a nie udział treści maszynowej w sieci; to inny mianownik niż w tabeli powyżej.
| Badanie | Co mierzono | Materiał | Wynik |
|---|---|---|---|
| Liang i in., 2023 | fałszywe alarmy siedmiu narzędzi komercyjnych | 91 esejów TOEFL, 88 esejów uczniów amerykańskich | 61,22% fałszywych alarmów dla autorów nienatywnych; dokładność bliska bezbłędnej dla natywnych |
| Jiang i in., 2024 (recenzowane) | trafność własnego klasyfikatora i obecność stronniczości | duża próba esejów z egzaminu GRE | wysoka trafność; brak dowodu stronniczości wobec autorów nienatywnych |
| PolEval ŚMIGIEL, 2025 | trafność systemów dla języka polskiego | 64 tys. próbek, sześć domen, osiem modeli generujących | 92,53% na głównym zbiorze; 61% na podzbiorze łączącym nieznany model z nową domeną |
| Al Ali i in., 2026 (preprint) | obecność stronniczości w języku czeskim | korpusy czeskie, porównanie z danymi angielskimi Lianga | brak istotnej różnicy między autorami natywnymi a nienatywnymi; entropia nienatywnych wyższa (3,48 wobec 3,19) |
Wniosek z tego zestawienia jest jeden i jest to wniosek o ostrożności: wynik detektora obowiązuje w warunkach, w których go zmierzono, i nie przenosi się automatycznie na inne narzędzie, inny język ani inną domenę tekstu.
Co zrobił LinkedIn i czego z tej liczby nie wynika
LinkedIn udostępnił pod koniec lipca 2026 opcję zgłaszania wpisów jako treści niskiej jakości generowanej przez AI, a trzy tygodnie później podał pierwsze wyniki. Według wypowiedzi Hariego Srinivasana, dyrektora produktu serwisu, przycisk kliknięto ponad milion razy, a treści, które serwis klasyfikuje w tej kategorii, zbierają o 40 procent mniej wyświetleń niż kilka tygodni wcześniej.
Srinivasan zaznaczył jednocześnie dwie rzeczy, które tę liczbę istotnie zawężają. Pojedyncze zgłoszenie nie decyduje o dystrybucji treści, a serwis bierze pod uwagę wiele sygnałów naraz i wprowadził zabezpieczenia mające zapobiegać wykorzystywaniu zgłoszeń przeciwko konkretnym osobom. Rozróżnia też treść bezwartościową od tekstu redagowanego z pomocą modelu, mówiąc wprost, że sztuczna inteligencja i materiał niskiej jakości to nie to samo.
Z liczby 40 procent nie wynika, o ile spada zasięg konkretnego wpisu. Jest to wielkość zagregowana dla całej kategorii, którą serwis sam definiuje, a spadek może pochodzić z obniżenia dystrybucji, ze zmiany klasyfikatora, ze zmniejszenia liczby takich materiałów albo z kombinacji tych mechanizmów.
Nieujawnione pozostają kryteria klasyfikacji, więc nie wiadomo, czy w grę wchodzi detektor statystyczny, sygnały behawioralne, zgłoszenia użytkowników, czy wszystkie naraz. Czy mechanizm serwisu wykazuje stronniczość opisaną przez Lianga, również nie wiadomo, ponieważ operator nie ujawnia, czy w ogóle korzysta z sygnałów tego rodzaju.
Autorzy mają być informowani o zgłoszeniach w statystykach wpisu, co jest jedyną informacją zwrotną dostępną firmie publikującej. Serwis zapowiedział też wycofanie funkcji automatycznego ulepszania wpisu i zastąpienie jej narzędziem, które poprawia tekst bez zmiany stylu autora.
Co z tego wynika dla firmy publikującej treści
Dla firmy praktyczna konsekwencja nie brzmi „detektory są zawodne, więc można je ignorować”, tylko „wynik detektora jest sygnałem o tekście, a nie dowodem o autorze, i przy zmianie języka, domeny albo narzędzia przestaje się przenosić”. Dwie rzeczy są przy tym udokumentowane niezależnie od siebie: klasyfikacja autorstwa na podstawie samego tekstu potrafi generować systematyczne błędy, a co najmniej LinkedIn wykorzystuje klasyfikację treści jako jeden z sygnałów wpływających na dystrybucję.
Ogniwa między tymi dwiema rzeczami brakuje i nie należy go dorabiać. Nie wiadomo, czy mechanizm stosowany przez ten serwis albo przez jakikolwiek inny wykazuje stronniczość opisaną w badaniach naukowych, ponieważ operatorzy swoich klasyfikatorów nie opisują.
Trzy warstwy, w których ma to znaczenie w firmie zatrudniającej od 50 do 500 osób:
- Marketing i sprzedaż: treści publikowane w serwisach społecznościowych mogą podlegać klasyfikacji operatora, której kryteriów firma nie zna, a informacja zwrotna dociera do autora dopiero przez statystyki wpisu.
- Rekrutacja: listy motywacyjne i zadania rekrutacyjne bywają sprawdzane detektorami, a przy rekrutacji międzynarodowej wynik badania z 2023 roku tworzy ryzyko nierównego traktowania kandydatów piszących po angielsku jako drugim języku.
- Dokumentacja i oferty: materiały przesyłane klientom zagranicznym mogą być przez nich sprawdzane narzędziem, o którego progu i metodzie firma nic nie wie.
Sensowna reakcja nie polega na unikaniu narzędzi ani na obchodzeniu detektorów. Polega na tym, żeby firma wiedziała, które jej treści przechodzą przez cudzy klasyfikator i co się dzieje, gdy klasyfikator zadziała. To pytanie o ewidencję i o właściciela procesu, nie o technologię.
Kluczowe pytania i decyzje
Czy powinienem przestać używać modeli do redagowania treści firmowych?
Nie, jeśli tekst przechodzi normalną kontrolę merytoryczną i redakcyjną, a rozważanym ryzykiem jest widoczność, nie odpowiedzialność prawna.
Tak, w zakresie dokumentów, w których odbiorca wprost zastrzegł brak udziału AI, bo tam problemem jest zobowiązanie umowne, a nie detektor.
Czy warto sprawdzać własne treści detektorem przed publikacją?
Tak, jeśli traktujesz wynik jako sygnał o stylu i używasz konsekwentnie jednego narzędzia, żeby porównywać między sobą własne teksty.
Nie, jeśli miałby to być warunek dopuszczenia tekstu do publikacji, bo przy udokumentowanych fałszywych alarmach oznacza to odrzucanie części tekstów dobrych.
Czy mogę przenieść wyniki badań anglojęzycznych na treści polskie?
Nie w zakresie stronniczości wobec autorów nienatywnych, bo badanie na języku czeskim (2026) dało wynik odwrotny do angielskiego.
Tak w zakresie ogólnej ostrożności wobec progu i domeny, bo zadanie ŚMIGIEL (2025) pokazało spadek trafności z 92,53% do 61% przy zmianie modelu i domeny.
Czy firma potrzebuje wewnętrznej polityki w tej sprawie?
Tak, jeśli publikuje regularnie w kanałach, których operator stosuje klasyfikację treści, albo prowadzi rekrutację międzynarodową.
Nie, jeśli publikacja jest okazjonalna, a odbiorcy nie stawiają wymogów co do udziału AI; wtedy wystarczy odnotować ryzyko w rejestrze i wrócić do niego przy zmianie skali.
Kiedy ta analiza się nie sprawdzi
Wynik z 2023 roku nie opisuje detektorów z 2026 roku. Badanie Lianga objęło siedem ówczesnych narzędzi komercyjnych. Jiang, Hao, Fauss i Li („Computers & Education”, 2024, recenzowane) zbudowali klasyfikator na dużej próbie esejów z egzaminu GRE, uzyskali wysoką trafność i nie znaleźli dowodu stronniczości wobec osób nienatywnie władających angielskim. To nie dowodzi, że problem zniknął z produktów komercyjnych; dowodzi, że stronniczość nie jest nieuchronną własnością detekcji tekstu.
Deklaracje producentów nie są pomiarem niezależnym. Dostawcy detektorów publikują własne testy z bardzo niskimi odsetkami fałszywych alarmów dla autorów nienatywnych. Traktuję je jako dane producenta o własnym produkcie, a nie jako weryfikację zewnętrzną.
Liczba 40 procent pochodzi od operatora, który jest stroną. LinkedIn ocenia skuteczność własnego mechanizmu, nie ujawniając metody, populacji ani punktu odniesienia, a samo zdanie dopuszcza dwa odczytania.
Sam Pew ostrzega przed swoim narzędziem, choć nie tak mocno, jak sugerowałaby jedna wyrwana liczba. Autorzy piszą wprost, że modele detekcyjne nie są doskonałe i mylą się w obie strony. Ich model otwarty zgadzał się z wersją komercyjną w 96 procentach przypadków, przy wartości kappa Cohena równej 0,61, czyli przy zgodności umiarkowanej na poziomie pojedynczej strony. Autorzy zaznaczają jednocześnie, że wartości zagregowane obu modeli były do siebie zbliżone, więc ogólny trend wzrostu udziału treści maszynowej okazał się niezależny od wyboru modelu. Wskaźników czułości i swoistości nie podają.
Argument da się odwrócić. Znaczna część treści zgłaszanych w serwisach społecznościowych zapewne rzeczywiście jest bezwartościowa, a firma narzekająca na filtr bywa jednym z autorów takiej treści. Teza tego tekstu dotyczy granic wnioskowania z wyniku detektora, a nie tego, że każda ukarana treść była dobra.
Podsumowanie
Detektory treści AI odpowiadają na inne pytanie, niż się od nich oczekuje. Pytane o autorstwo, zwracają pozycję na skali ufności klasyfikatora, która zależy od metody, danych treningowych, progu, języka i domeny. Wynik 61,22 procent fałszywych alarmów z badania opublikowanego w „Patterns” w 2023 roku jest skrajnym przykładem tego, co się dzieje, gdy któryś z tych czynników zostanie zignorowany, a nie stałą właściwością kategorii narzędzi.
Nowsze prace komplikują obraz w sposób, który dla polskiego czytelnika jest akurat istotny. Badanie na danych z egzaminu GRE stronniczości nie potwierdziło, badanie na języku czeskim dało wynik odwrotny do angielskiego, a polskie zadanie ŚMIGIEL pokazało, że skuteczność wykrywania spada z ponad 92 procent do około 61 procent na podzbiorze, w którym jednocześnie zmienia się model generujący i domena tekstu. To jest realny obraz: technologia mierzalna, lecz krucha poza warunkami, w których ją zmierzono.
Praktyczna konsekwencja dla firmy jest węższa, niż sugerują nagłówki. Nie chodzi o rezygnację z modeli ani o uczenie się obchodzenia detektorów. Chodzi o świadomość, że część treści firmowych przechodzi przez cudzy klasyfikator, którego progu i metody firma nie zna, a którego skuteczność na materiałach tego rodzaju pozostaje nieznana, choć skutki jego działania widać w kanałach traktowanych jako własne. To pozycja do rejestru ryzyk i pytanie o właściciela procesu, nie problem do rozwiązania narzędziem.
O autorze
Remigiusz Pruszczak: ekspert GenAI i trener AI. Od 17 lat prowadzi szkolenia, a od 2025 roku również z generatywnej AI, między innymi dla banków, instytucji finansowych, kancelarii oraz firm z sektorów regulowanych i produkcji. Szkolenia realizuje we współpracy z EY Academy of Business Polska, Warszawskim Instytutem Bankowości, Bankowym Ośrodkiem Doradztwa i Edukacji oraz CFA Society Poland. Więcej na stronie „O mnie”.
Źródła
- Liang W., Yuksekgonul M., Mao Y., Wu E., Zou J., „GPT detectors are biased against non-native English writers”, Patterns (Cell Press), 2023. https://www.cell.com/patterns/fulltext/S2666-3899(23)00130-7
- Jiang Y., Hao J., Fauss M., Li C., „Detecting ChatGPT-generated essays in a large-scale writing assessment: Is there a bias against non-native English speakers?”, Computers & Education, t. 217, 2024. https://doi.org/10.1016/j.compedu.2024.105070
- Al Ali A., Helcl J., Libovický J., „Different Time, Different Language: Revisiting the Bias Against Non-Native Speakers in GPT Detectors”, arXiv:2602.05769, 2026. https://arxiv.org/abs/2602.05769
- Przybyła P., Strebeyko J., Wróblewska A., „PolEval 2025 Task 1 Śmigiel: Spotting Machine-Generated Text from LLMs for Polish”, Proceedings of the PolEval 2025 Workshop, 2025. https://aclanthology.org/2025.poleval-main.2/
- Wróbel K., „Unsupervised Detection of LLM-Generated Polish Text Using Perplexity Difference”, Proceedings of the PolEval 2025 Workshop, 2025. https://aclanthology.org/2025.poleval-main.5/
- Pew Research Center, „How much of the internet is written with AI?”, 2026. https://www.pewresearch.org/data-labs/2026/08/20/how-much-of-the-internet-is-written-with-ai/
- Pew Research Center, nota metodologiczna do powyższego badania, 2026. https://www.pewresearch.org/data-labs/2026/08/20/methodology-ai-content/
- Graphite, „AI now writes as many online articles as humans do”, maj 2026. https://graphite.io/five-percent/research/ai-now-writes-as-many-online-articles-as-humans-do
- TechCrunch, „LinkedIn adds a button to report AI-generated slop”, 30 lipca 2026. https://techcrunch.com/2026/07/30/linkedin-adds-a-button-to-report-ai-generated-slop/
- Engadget, „LinkedIn says its AI slop button is working”, 21 sierpnia 2026. https://www.engadget.com/2241857/linkedin-says-its-ai-slop-button-is-working/
- Hari Srinivasan, dyrektor produktu LinkedIn, wpisy dotyczące zgłaszania treści niskiej jakości, 20 sierpnia 2026. Cytaty przytaczane za relacjami wymienionymi niżej
- Social Media Today (A. Hutchinson), „LinkedIn says 1M people have reported AI slop”, 20 sierpnia 2026. https://www.socialmediatoday.com/news/linkedin-says-1m-people-have-reported-ai-slop/828465/
- Medianama, „How LinkedIn distinguishes AI slop from AI-assisted writing”, 24 sierpnia 2026. https://www.medianama.com/2026/08/223-linkedin-ai-slop-ai-assisted-writing/